L’IA progresse, tandis que la réglementation, les droits et la société civile tentent de la suivre sans réel consensus.
Initialement publié le Global Voices en Français

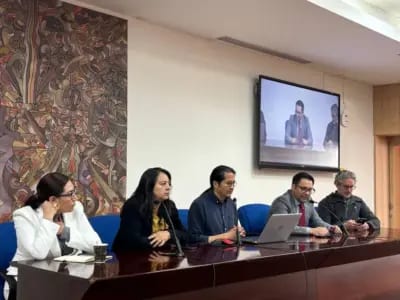
De gauche à droite : Mónica Reinoso (Defensoría del Pueblo), Susana Cadena (Datalat), Carlos E. Flores (Openlab), Marco Insuasti (Mintel) et Rafael Bonifaz (Derechos Digitales). Photo : Openlab Équateur, utilisée avec autorisation.
Cet article fait partie du dossier spécial d'avril 2026 de Global Voices sur les « Perspectives humaines sur l'IA », qui a apporté un éclairage sur la manière dont l'IA est utilisée dans les pays de la majorité mondiale. Le dossier a notamment examiné l'impact de l'utilisation de l'IA et de sa mise en œuvre sur les différentes communautés, ce que cette expérience en matière d'IA pourrait signifier pour les générations futures, et bien plus encore. Pour soutenir ce projet, vous pouvez faire un don ici.
Une personne consulte son téléphone, tape une question et obtient une réponse en quelques secondes. Elle ne sait pas comment ça fonctionne, quelles données elle a divulgué, ni qui se cache derrière cette réponse. Pourtant, elle continue à l’utiliser.
L’intelligence artificielle intervient déjà dans les devoirs scolaires, les décisions professionnelles, et les processus qui nécessitaient auparavant des heures. Elle donne des résultats. Elle s’intègre. Elle progresse. En Équateur, il n’existe pas de politique coordonnée en matière d’IA ; les initiatives avancent plutôt de manière isolée. Les ministères, l’Assemblée nationale (le Congrès), les organismes de régulation et le monde universitaire font chacun valoir leurs propres propositions, avec des priorités et des calendriers divergents. Ainsi, il en résulte des lois, des stratégies et des réglementations qui ne s’articulent pas les unes avec les autres, voire se superposent, sans ligne directrice commune.
Alors que les technologies d’IA sont de plus en plus présentes dans la vie quotidienne, les décisions concernant leur utilisation, leurs limites et leurs conséquences restent très éloignées des personnes qui les utilisent.
Dans ce contexte, fin 2025, plus de 60 personnes se sont réunies à la FLACSO Équateur autour du thème « Intelligence artificielle et droits numériques : différentes perspectives au service du bien commun », dans le but d’ouvrir un débat qui, jusque-là, se limitait à des cercles restreints.
Cette rencontre a été organisée par Openlab, en coordination avec Futuroscon.IA et le CTS Lab de la FLACSO Équateur, et avec le soutien d’un projet financé par Probox. Cette initiative a permis de réunir au sein d’un même espace des organisations sociales, des universitaires et des institutions publiques, ainsi que divers acteurs impliqués dans le débat sur l’intelligence artificielle et les droits numériques. La table ronde principale réunissait la Defensoría del Pueblo (l’institution nationale des droits humains du pays), Derechos Digitales, Datalat et le ministère des Télécommunications (MINTEL).
En plus de cette table ronde, la journée a également été marquée par des conférences visant à élargir le débat en l’abordant sous d’autres angles. Jonathan Finlay, de l’organisation LaLibre, a par exemple ancré la discussion dans le présent : l’intelligence artificielle influence déjà les décisions, sans que l’on ait encore une compréhension claire de ses effets. Pour sa part, Martha Tudón, de Artículo 19, a orienté la discussion vers la surveillance, l’utilisation des données, et les risques pour les droits dans des contextes dépourvus de mécanismes de contrôles clairs.
Au CTS Lab de la FLACSO, la question a pu être envisagée d’une autre manière grâce à l’outil RAM, développé par l’UNESCO. Il ne s’agissait plus de savoir ce que l’intelligence artificielle est capable de faire, mais si le pays est prêt à la porter et à l’encadrer. Cet outil évalue la législation, les capacités institutionnelles, la protection des droits et le niveau de compréhension du public d’un pays, afin de déterminer si ces technologies d’IA peuvent être utilisées à plus grande échelle sans que l’on perde le contrôle sur leurs effets.
Au cours du Forum ouvert, format collaboratif dans lequel les participants et participantes définissent collectivement les thèmes de discussion, cette question s’est traduite par des cas concrets. À la table consacrée à la vie privée, les participants ont par exemple évoqué le cas d’un employé d’un hôpital public qui, pour pouvoir organiser son travail, faute d’outils institutionnels, avait saisi des données médicales sensibles sur des plateformes d’intelligence artificielle à partir d’un compte personnel. À l’heure actuelle, il n’existe aucune directive claire concernant ce type d’utilisation, ni de système de contrôle efficace sur la manière dont ces informations sont traitées ou protégées.
Dans le secteur de l’éducation, le problème se manifeste différemment. En effet, les étudiants ont désormais recours à des outils d’intelligence artificielle pour réaliser leurs travaux, rédiger leurs dissertations, ou même se forger des opinions sans s’imprégner pleinement du contenu. Des pratiques qui nuisent au développement d’un jugement indépendant et critique. Parallèlement, en l’absence d’outils clairs pour intégrer ces technologies dans le processus d’apprentissage ou pour encourager une utilisation plus réfléchie et responsable, une partie de la communauté pédagogique hésite entre l’interdiction pure et simple, et une approche axée sur la lutte contre le plagiat.
En matière d’inclusion et d’égalité des genres, les discussions ont porté sur le fait que les systèmes sont actuellement entraînés à partir de données qui excluent les savoirs des peuples autochtones, des personnes d’ascendance africaine et des communautés locales. Cela a non seulement pour effet de reproduire ces absences dans les processus décisionnels, mais aussi de renforcer une forme dominante de savoir, centrée sur les perspectives occidentales et scientifiques, qui finit par supplanter les autres façons de comprendre et de vivre la réalité.
Du point de vue de la gouvernance, les conversations ont mis en évidence un problème fondamental : l’aspect de l’intelligence artificielle que l’on souhaite réglementer n’est pas encore clair. Vaut-il mieux s’intéresser à son utilisation, à son développement, aux investissements ou aux décisions automatisées ? À ce manque de clarté s’ajoutent le fait d’adopter des modèles externes sans tenir compte du contexte local, et le risque d’évoluer vers des mesures de contrôle s’avérant excessives pour un écosystème encore en formation. Dans ce contexte, la réglementation risquerait de devenir trop vaste, peu opérationnelle et difficile à mettre en œuvre dans la pratique.
Outre les tables rondes, ce débat commençait déjà à prendre forme à l’Assemblée nationale. Néanmoins, bien que des espaces de discussion aient été ouverts, ceux-ci n’ont pas nécessairement réussi à susciter une participation plus large. Tout au long de l’année 2024, l’Assemblée nationale a reçu trois projets de loi qui se concentraient chacun sur des aspects différents, de la recherche à la commercialisation des systèmes d’intelligence artificielle à travers des thèmes tels que la protection des données, la transparence, ou encore les droits d’auteur, en passant par la protection des enfants et des adolescents face à l’utilisation de ces technologies.
Toutefois, depuis la fusion de ces projets de loi sur l’intelligence artificielle, le débat n’a pas connu d’avancées visibles ces derniers mois. Dans divers cercles, on commence à évoquer la possibilité de voir cette initiative classée sans suite, sans qu’il y ait pour l’instant de perspective claire quant à son avenir.
Alors que le débat réglementaire reste au point mort, des acteurs ayant une réelle capacité à influencer le développement et l’utilisation de ces technologies commencent à gagner du terrain. Lors du Forum économique mondial de Davos, le président équatorien Daniel Noboa a rencontré Alex Karp, PDG de Palantir, l’une des entreprises les plus influentes au monde dans le domaine de l’analyse de données à grande échelle. Ayant notamment collaboré avec des agences telles que la CIA, le FBI ou les services d’immigration américains, cette entreprise a développé son expertise dans l’intégration de vastes volumes d’informations à des fins de sécurité et de renseignement.
Avec l’annonce de l’ouverture d’un bureau en Équateur, l’éventuelle implantation de Palantir dans le pays intervient à un moment où les règles ne sont pas encore clairement définies, et ce, dans un domaine où une même technologie est tout aussi capable d’optimiser les services que de développer des formes de surveillance difficiles à contrôler.
Par ailleurs, le 10 mars 2026, le gouvernement équatorien a présenté la « Stratégie pour la promotion du développement et de l’utilisation éthique et responsable de l’intelligence artificielle en Équateur » (EFIA-EC), promue par le ministère des Télécommunications et de la Société de l’information du pays avec le soutien de la BID et de l’UNESCO. Cette proposition présente une feuille de route sur quatre ans, articulée autour de trois axes : gouvernance, capacités humaines et technologiques, adoption et développement. Son objectif est explicite : faire en sorte que l’intelligence artificielle ne soit pas l’apanage d’une minorité, mais un outil au service des citoyens, de l’État et du développement productif.
Dans ce contexte, les résultats des travaux de la réunion d’octobre, consignés dans un compte-rendu élaboré à partir de ces tables rondes thématiques, ont commencé à circuler parmi les participants, et ont été transmis au ministère des Télécommunications, organe directeur, ainsi qu’à la Defensoría del Pueblo, à un moment où ces technologies s’inscrivent de plus en plus dans les débats sur les droits numériques et la protection des droits humains.
Entre stratégie, réglementation en suspens et adoption croissante de ces technologies, le pays évolue dans un contexte encore instable, où le développement avance plus vite que la définition de ses limites.


